単体カード2枚か、NVLink対応のDualカードか
Tesla V100を使っていろいろ遊んでいますが、ローカルでLLMを動かしているとどうしてもVRAM不足にぶつかります。32GBに載らないモデルを動かそうと思えば、もう1枚V100を買ってGPUを2枚にするしかありません。(力業)
そこで悩むのが、Tesla V100 32GBの単体カードを2枚搭載するか、あるいはV100が2基載ったNVLink接続のカードを1枚買うかと、いう点です。NVLinkは「GPU同士を高速な専用線で直結する技術」で、スペック上はPCIe経由の通信より桁違いに速いです。ただ、それが実際の推論速度にどれだけ効くのかという情報が、探してもほとんど見つかりませんでした。
であれば自分で測ってみよう、ということで同じV100 32GB×2の環境を2台組んで、比較してみました。
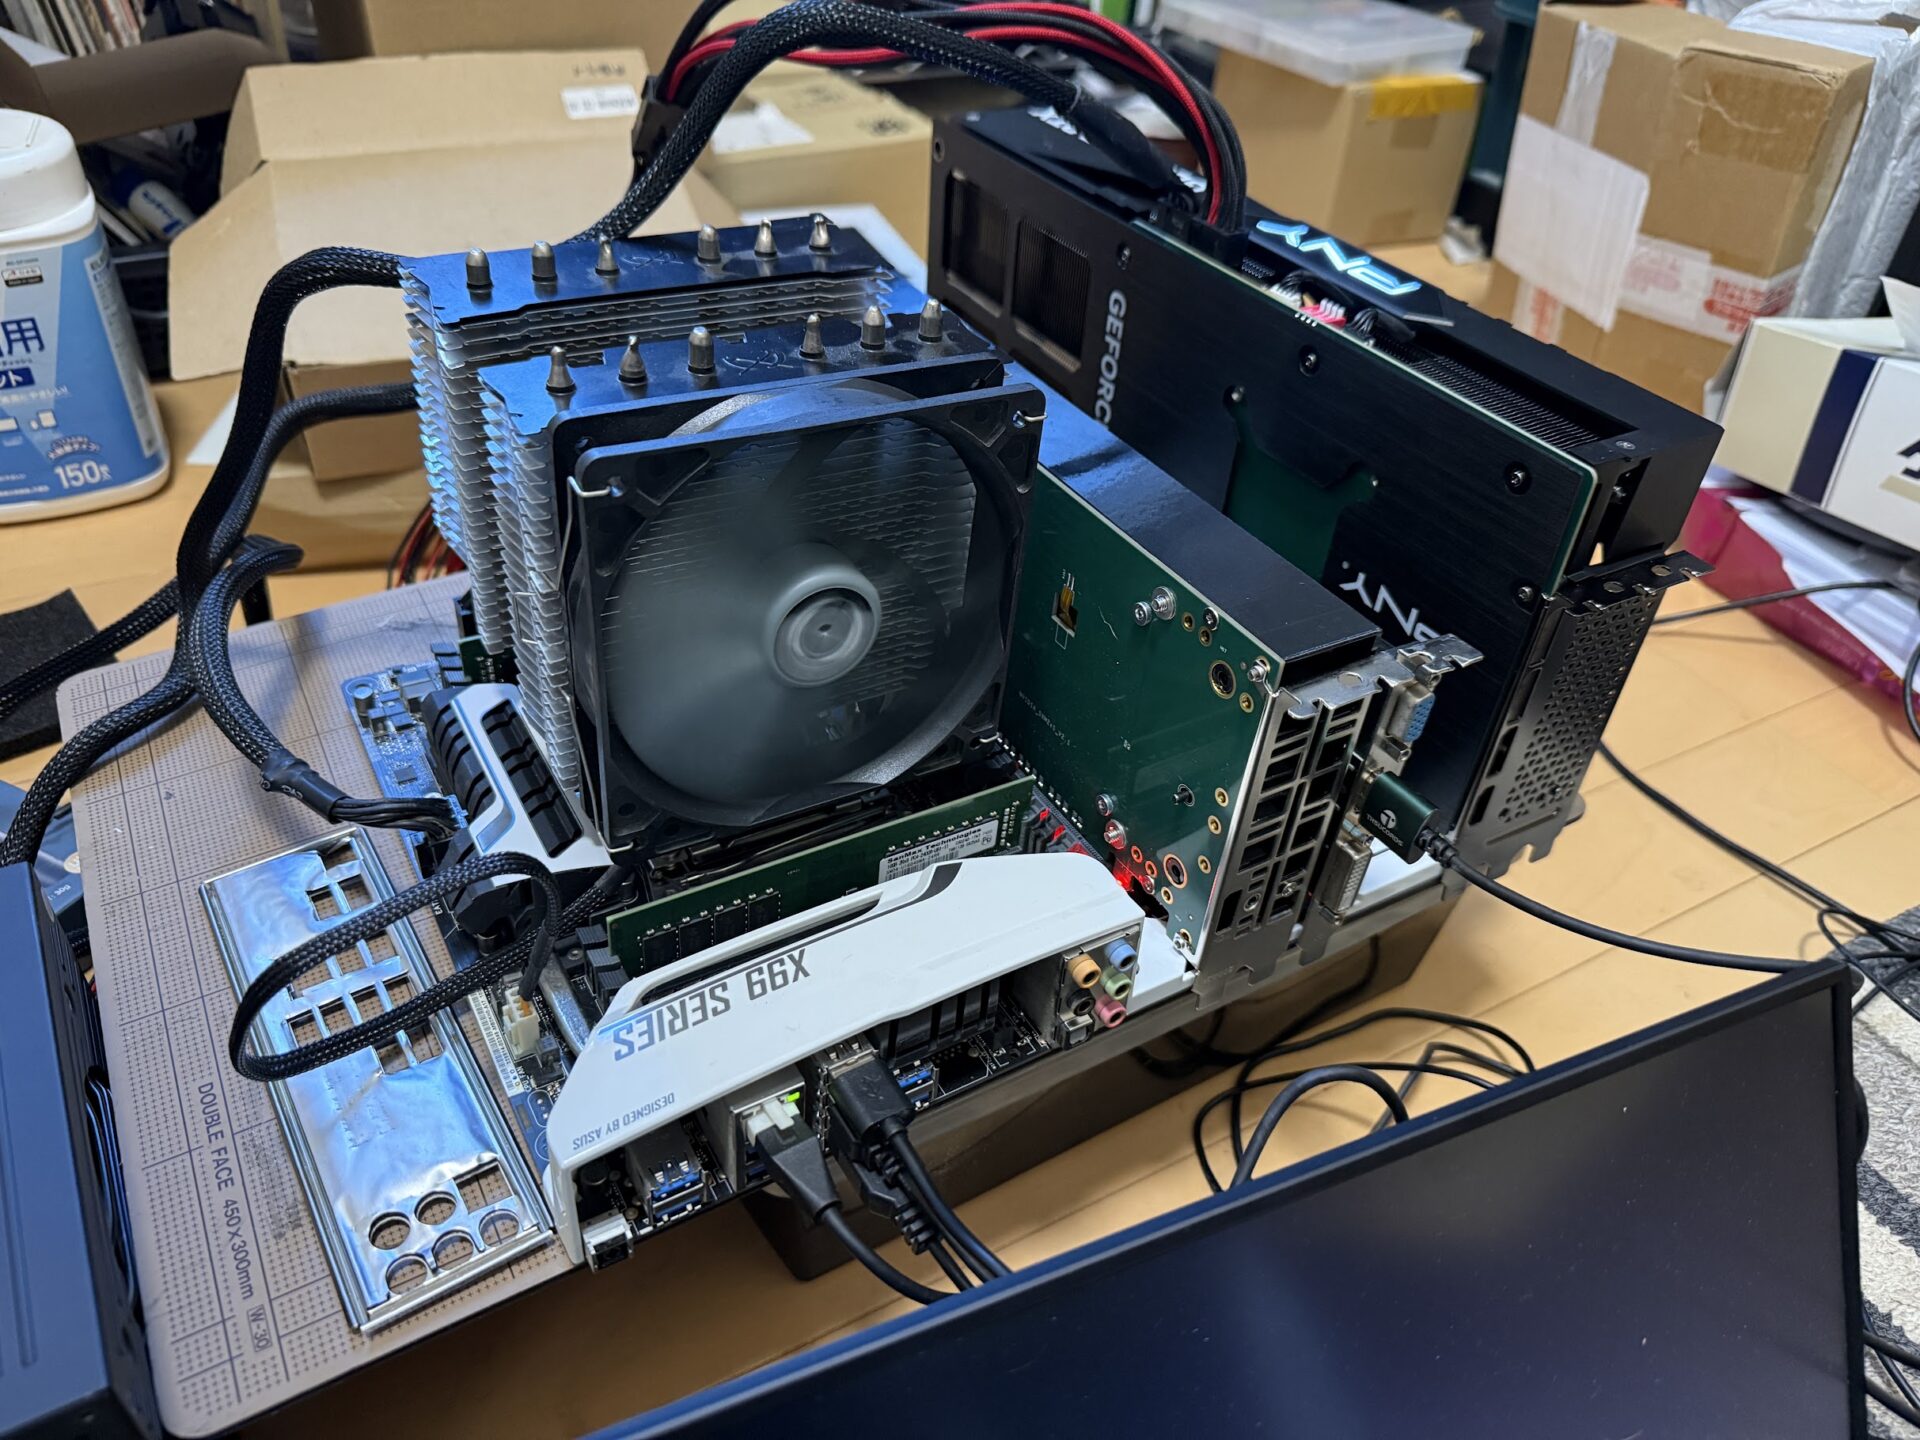
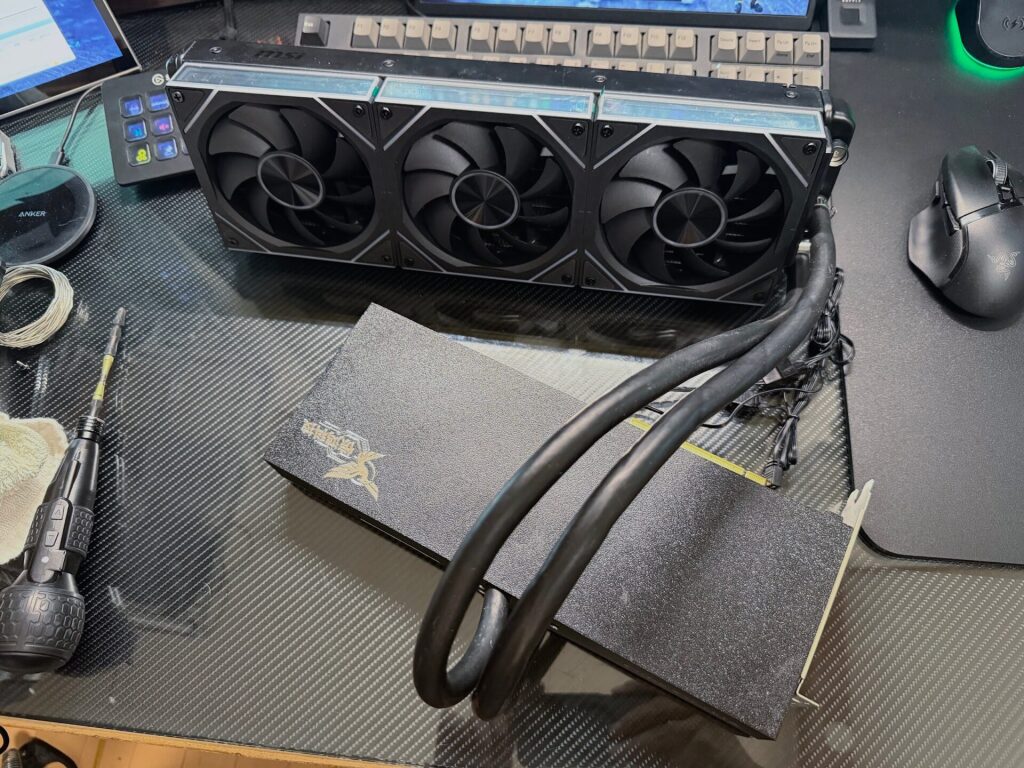
片方はSXM2→PCIe変換アダプタでV100の単体カードを2枚挿したPC、もう片方はカード上でNVLink接続されたV100 Dualカードを挿したPCです。
先に結果をお伝えすると、使うソフトウェア次第でまるっと変わるというのが答えでした。しかも、NVLinkが効く場所が予想とかなり違っていて、正直、“VRAM32GBを溢れる使い方ならNVlinkの方が速いだろう”と思っていた節があるのですが、かなり異なる結果となりました。
検証環境について
比較の肝は「GPU間の接続方式以外をなるべく揃えること」ですが、今回は諸事情でX99とX299プラットフォームを使用しています。この違いによる性能差は後ほどご説明します。
どちらもTesla V100-SXM2-32GBを2基使い、電力上限もドライバのバージョンも同じに揃えました。
| A機:PCIe接続 | B機:NVLink接続 | |
|---|---|---|
| GPU | V100-SXM2-32GB ×2枚 | V100-SXM2-32GB ×2基(1枚のカード) |
| 搭載方法 | SXM2→PCIe変換アダプタ(空冷ファン付き) | 2基載りカードをそのまま装着 |
| GPU間の接続 | PCIe Gen3 x8 | NVLink 2.0(6リンク) |
| マザー | ASUS X99-S (X99) | ASUS Rampage VI Extreme (X299) |
| CPU | Core i7-5930K(6コア) | Core i9-7920X(12コア) |
| メモリ | 32GB | 64GB |
| 電力上限 | 300W | 300W |
| ドライバ | 580.178.04 | 580.178.04 |
SXM2版のV100は本来サーバー専用ですが、中国製のSXM2→PCIe変換アダプタを使用しています。一方のNVLinkカードは、2基のV100が基板上で直結された状態で1枚になっているタイプで、PCIe x16をx8/x8に分割して使う構造です。
なお、A機は2枚目のV100カードがあまりにも馬鹿でかく、物理的な干渉で2枚ともPCIe x16スロットに装着することができず、x8/x8での動作になりました。結果的には、ホスト側の帯域は両機ともx8で揃ったので、比較条件としてはむしろ好都合でした。
GPU間の通信速度は「23.6倍」違う
まず、GPU同士がどれくらいの速さでデータをやり取りできるのかを実測しました。
PyTorchでGPU間コピーを走らせた結果がこちらです。
| A機:PCIe Gen3 x8 | B機:NVLink | |
|---|---|---|
| GPU間の実測帯域 | 5.20 GB/s | 122.7 GB/s |
| 小さいデータの往復遅延 | 22.1 µs | 17.5 µs |
| 倍率 | — | 約23.6倍 |
帯域は23.6倍。これだけ見ると「NVLink圧勝、以上」で記事が終わりそうな予感がします。
ですが、注目してほしいのは遅延のほうで、こちらは22.1µs対17.5µsと1.26倍の差しかありません。この「帯域は桁違いだが遅延はあまり変わらない」というのが今回の検証で予想と違う結果となる要因かと思います。
3種類ある、2枚のGPUの使い方
ここが今回一番お伝えしたいポイントです。GPUを2枚使うと言っても使い方は3通りあり、それぞれの方式でGPU間の通信量がまったく異なります。
| 方式 | どう分けるか | GPU間通信 | 使えるソフト |
|---|---|---|---|
| レイヤー分割 | モデルの前半をGPU0、後半をGPU1に置く | ほとんど無し | Ollama |
| パイプライン並列 | 同上(vLLM版) | 少ない | vLLM |
| テンソル並列 | 各層の計算そのものを2基で分担 | 毎回大量に発生 | vLLM |
レイヤー分割
レイヤー分割は「前半を計算し終わったらバトンを渡す」イメージです。受け渡しのデータ量はごくわずかで、渡すのは境界の1か所だけ、しかも中身はその時点の計算結果だけです。GPU間通信がほとんど無いので、NVlinkの圧倒的なGPU間という強みがほぼ生かせません。
パイプライン分割
パイプライン並列は、レイヤー分割の「前半・後半で分ける」という考え方をvLLMで実装したものです。基本の仕組みはレイヤー分割と同じで、GPU間でやり取りするのは境界を通過するデータだけ。違いは、複数のリクエストを小分けにして流し込むことで、前半を担当するGPUが次のリクエストに取りかかり、後半のGPUと同時に動ける点です。
通信量が小さいという性質はレイヤー分割と変わらないので、NVLinkの効き方という観点ではレイヤー分割と同じグループと考えて差し支えありません。
テンソル分割
テンソル並列は「1つの計算を2基で手分けして、毎回結果を突き合わせる」方式です。層を通過するたびに通信が走るので、前の2つの方式とは通信量の桁が変わります。その代わり、2基のGPUが常に同時に働くため、うまくハマれば最も速くなるのも、このテンソル並列の特徴です。
つまりNVLinkが効くかどうかは、この使い方次第ということになります。パイプライン分割とテンソル分割はvLLMでのみ利用可能なので、Ollamaしか使わない人にはNVlinkは関係ない話かもしれない…という予感がすでにここでしてきます。
測定条件
- モデル
Llama 3.3 70B(AWQ 4bit、約40GB)
32GB 1枚には載らない、GPUが2基必須のサイズとしました。 - エンジン
Ollama 0.34.2 と 1Cat-vLLM v1.5.0(V100向けに最適化されたvLLMのフォーク) - プロンプト長
約3.2K/12.9K/51.4Kトークンの3パターン - 出力
256トークン固定、温度0、シード固定、ウォームアップ後に5回測定した中央値
測る指標は以下の2つに分けました。
- TTFT(最初の1文字が出るまでの時間)= プロンプトを読み込む処理(prefill)の速さ
- decode(トークン生成速度、tok/s)= 文章を吐き出す速さ
わかりやすく説明すると、
TTFTは「送信してから返事が始まるまでの待ち時間」
decodeは「返事がスラスラ流れる速さ」
となります。
結果①テンソル並列:待ち時間は激減、生成速度は不変
まずは本命、vLLMのテンソル並列です。Llama 3.3 70Bでの結果がこちら。
| プロンプト長 | TTFT(PCIe) | TTFT(NVLink) | 短縮率 | decode(PCIe) | decode(NVLink) | 改善率 |
|---|---|---|---|---|---|---|
| 約3.2K | 6.14秒 | 4.01秒 | -34.7% | 24.4 tok/s | 25.1 tok/s | +2.7% |
| 約12.9K | 31.38秒 | 22.97秒 | -26.8% | 18.6 tok/s | 19.1 tok/s | +2.7% |
| 約51.4K | 235.7秒 | 201.2秒 | -14.6% | 9.7 tok/s | 9.9 tok/s | +2.5% |
| 8並列 | 29.58秒 | 19.84秒 | -32.9% | 6.3 tok/s | 7.9 tok/s | +25.5% |
はっきり傾向が出ました。
TTFT(待ち時間)は最大34.7%短縮。プロンプト処理の速度に換算すると、3.2Kトークンで527 tok/s → 806 tok/s と53%も向上しています。
ところがdecode(生成速度)はどれも2.5〜2.7%しか変わりません。実はこの約2.5%は誤差の範囲となります。というのも、今回用いた2台のPCのプラットフォームが異なるため、GPU間通信が一切発生しない単一GPUでの測定でも両機に2.5%の差があったからです。
つまりこの2.7%はマザーボードやCPUの違いによる素の性能差であって、NVLinkの効果ではありません。
一方、8並列(同時に8リクエストを投げる条件)だけは様子が違い、decodeも+25.5%、全体スループットは28.9 → 38.9 tok/s と34%向上しました。
正直に言うと、検証前は「NVLinkにすれば生成速度が上がるだろう」と思っていましたが、完全に外れた結果となりました。
結果②Ollamaとパイプライン並列:まったく差が出ない
続いて、レイヤー分割(Ollama)とパイプライン並列(vLLM)です。
NVlinkが生かせないような気はしていましたが、結果を見ていただければ一目瞭然でした。
| 方式 | プロンプト長 | decode(PCIe) | decode(NVLink) | 改善率 |
|---|---|---|---|---|
| Ollama レイヤー分割 | 約3.2K | 16.0 tok/s | 16.4 tok/s | +2.1% |
| Ollama レイヤー分割 | 約12.9K | 15.1 tok/s | 15.4 tok/s | +2.0% |
| Ollama レイヤー分割 | 約51.4K | 12.3 tok/s | 12.4 tok/s | +1.5% |
| Ollama レイヤー分割 | 8並列 | 5.9 tok/s | 5.9 tok/s | +0.9% |
| vLLM パイプライン並列 | 約3.2K | 15.5 tok/s | 15.6 tok/s | +1.0% |
| vLLM パイプライン並列 | 約51.4K | 5.5 tok/s | 5.6 tok/s | +2.3% |
すべて0.9〜2.3%。先ほど述べた「素の性能差2.5%」の範囲内なので、NVLinkの効果はゼロと言い切って差し支えありません。
これは、レイヤー分割もパイプライン並列もGPU間でやり取りするデータ量がごく小さいので、NVLinkでGPU間の通信路が23.6倍速くなったところで、もともと混んでいない道が広がるだけの話です。
結論としては、Ollamaしか使わないなら、NVLinkは必要ありません。
もうひとつ、NVLinkとは別に見逃せない発見がありました。X99のPCIeカードを2枚挿したPCでの比較となります。
| 方式 | decode(3.2Kプロンプト) |
|---|---|
| vLLM テンソル並列 | 24.4 tok/s |
| Ollama レイヤー分割 | 16.0 tok/s |
| vLLM パイプライン並列 | 15.5 tok/s |
NVlinkが使えない、PCIe接続の環境でも、テンソル並列は他の方式より1.5倍以上速いのです。
GPUを2枚積むなら、NVLinkのカードを買うよりも先に、vLLMのテンソル並列を使うべき、というのが素直な結論になります。
NVLinkを切ってみた状態でのテスト
ここまでの比較ですが、2台のPCはマザーもCPUも違うので、「NVLinkのおかげ」なのか「X299のほうが単に速い」のか、厳密には言い切れない欠点があります。
そこでNVLink機だけで、NVLinkを無効にした状態でもう一度測定してみました。
環境変数NCCL_P2P_DISABLE=1を設定すると、GPU同士の直接通信をやめてホストメモリ経由になりますので、この条件で計測してみました。
| 条件(テンソル並列) | TTFT | decode |
|---|---|---|
| NVLink 有効 | 4.01秒 | 25.1 tok/s |
| NVLink 無効(同じPC) | 6.03秒 | 25.0 tok/s |
| PCIe機(参考) | 6.14秒 | 24.4 tok/s |
51.4Kの長いプロンプトでも同じ傾向でした。
| 条件(テンソル並列) | TTFT | decode |
|---|---|---|
| NVLink 有効 | 201.2秒 | 9.9 tok/s |
| NVLink 無効(同じPC) | 232.8秒 | 9.9 tok/s |
| PCIe機(参考) | 235.7秒 | 9.7 tok/s |
NVLinkを切った瞬間、TTFTはPCIe機とほぼ同じ値まで下がります(4.01→6.03秒、PCIe機は6.14秒)。一方でdecodeはまったく影響を受けません(25.1→25.0 tok/s)。
同じハードでの比較なので、マザーやCPUの差が入り込む余地がありません。
これで「待ち時間の短縮は間違いなくNVLinkの影響」「生成速度はそもそもNVLinkと関係ない」という結果が確定しました。
なぜ「待ち時間」だけが速くなるのか
理屈はシンプルで、通信量が処理するトークン数に比例するからです。
テンソル並列では、Transformerの各層を計算するたびに2基の結果を突き合わせる通信(all-reduce)が入ります。このとき流れるデータ量は、そのとき処理しているトークンの数に比例します。
| 処理 | 一度に扱うトークン数 | 通信量 | ボトルネック |
|---|---|---|---|
| prefill(プロンプト読み込み) | 数千〜数万 | 大きい | 帯域 |
| decode(1トークン生成) | 1 | ごく小さい | 遅延(+メモリ帯域) |
プロンプトを読み込むときは数千から数万トークンをまとめて処理するので、通信量が大きく、NVlinkの23.6倍の帯域差がそのまま効きます。ですので、TTFTが大きく縮む結果となります。
対して文章を生成するときは、1ステップで扱うのはたった1トークン。データ量が小さいので帯域は余っており、効いてくるのは遅延のほうです。そして冒頭で触れたとおり、V100の遅延差は22.1µs対17.5µsの1.26倍しかありません。しかもこのわずかな時間は、GPUが40GBの重みをVRAMから読み出す待ち時間の裏に隠れてしまうため、体感差にすらなりません。
8並列のときだけdecodeも+25.5%伸びたのは、8リクエストをまとめて処理すれば1ステップで扱うトークンが8個になり、prefillと同じ「通信量が大きい」状況に近づくためです。
つまり、NVLinkは「一度にたくさん処理するとき」に効く技術ということになります。
どちらを買うべきか
用途別にまとめてみました。
| 使い方 | おすすめ | 理由 |
|---|---|---|
| Ollamaで手軽に動かしたい | 単体カード×2 | 差は2%以内。NVLinkが丸ごと無駄になる |
| 短い質問を1件ずつ投げる | どちらでも可 | 待ち時間が6.1→4.0秒。体感差はあるが小さめ |
| 長文やRAGを日常的に投げる | NVLink | プロンプト処理が17〜53%高速 |
| 複数から同時アクセスがある | NVLink | スループット+34%。差が最も大きい |
| 将来GPUを増やす予定がある | NVLink | 並列度が上がるほど通信量が増える |
| 1枚に載るモデルしか使わない | 単体カード×1 | そもそも2枚不要 |
単発利用なら、差は思ったより小さい
私の主目的は「数分に1回程度、botから問い合わせる」用途となります。
この条件で計算すると、256トークンの応答が出揃うまでの時間は次のようになります。
| 待ち時間 | 生成時間 | 合計 | |
|---|---|---|---|
| PCIe | 6.1秒 | 10.5秒 | 16.6秒 |
| NVLink | 4.0秒 | 10.2秒 | 14.2秒 |
差は約14%。体感できなくはないですが、「数分に1回」の用途でこの差に追加コストを払うかというと、微妙なラインです。
こういう場合は迷わずNVLinkがお勧め
長いドキュメントを読ませるRAG構成や、会社やチームで共有する推論サーバーを立てるなら話は別です。同時8リクエストでスループット+34%という差は、実運用でははっきり効きます。
GPUを3枚4枚に増やす計画があるなら、なおさらNVLinkがお勧めです。
結論
今回のテストの結果ですが、NVLink対応のカードを買うかどうかより、vLLMのテンソル並列を使うかどうかのほうが影響が大きいという点です。
PCIeカード×2枚という環境でも、Ollamaの16.0 tok/sがvLLMのテンソル並列なら24.4 tok/sになります。NVLinkの効果(decodeで実質0%)より、エンジンを変える効果(+53%)のほうがはるかに大きいわけです。
ハードウェアに投資する前に、まずソフトウェアを見直すべき。というのが、実機2台を組んで電気代を払った末にたどり着いた、身も蓋もない結論でした。
まあ、水冷でNVLink接続のDualカードって、ハードウェアとしては面白いので買った意味はありますが、LLMの速度という点では微妙な感じです。
導入前に知っておきたい注意点
中古V100でLLM環境を組もうとしている方向けに、今回ハマった点・意外だった点をまとめておきます。
ホスト側はPCIe x8で十分
NVLinkカードはPCIe x16をx8/x8に分割して使う構造ですが、推論性能にはまったく影響しませんでした。GPU間の通信はNVLinkを通るので、ホスト側の帯域が効くのはモデルの読み込み時くらいです。PCIe機のほうもx8/x8でしたが、それでも問題なく動いています。「x16スロットが2本ないと駄目」と身構える必要はありません。
デュアルカードはマザーボードを選ぶ
NVLink対応のV100 Dualカードは、1本のPCIe x16スロットの中に2基のGPUが入っている構造なので、マザーボード側がx16を x8/x8 に分割(バイファーケーション)できる必要があります。対応していないと、2基のうち1基しか認識されず、せっかくの32GB×2が32GBになってしまいます。
厄介なのは、これがBIOSの対応次第で、ハイエンドのマザーでも非対応の場合があることです。比較的AMD環境の方がPCIeの分割に対応している場合が多いように思いますが、AMD環境ではGPU内蔵のCPU(APU)を使うと分割に対応できないので注意が必要です。
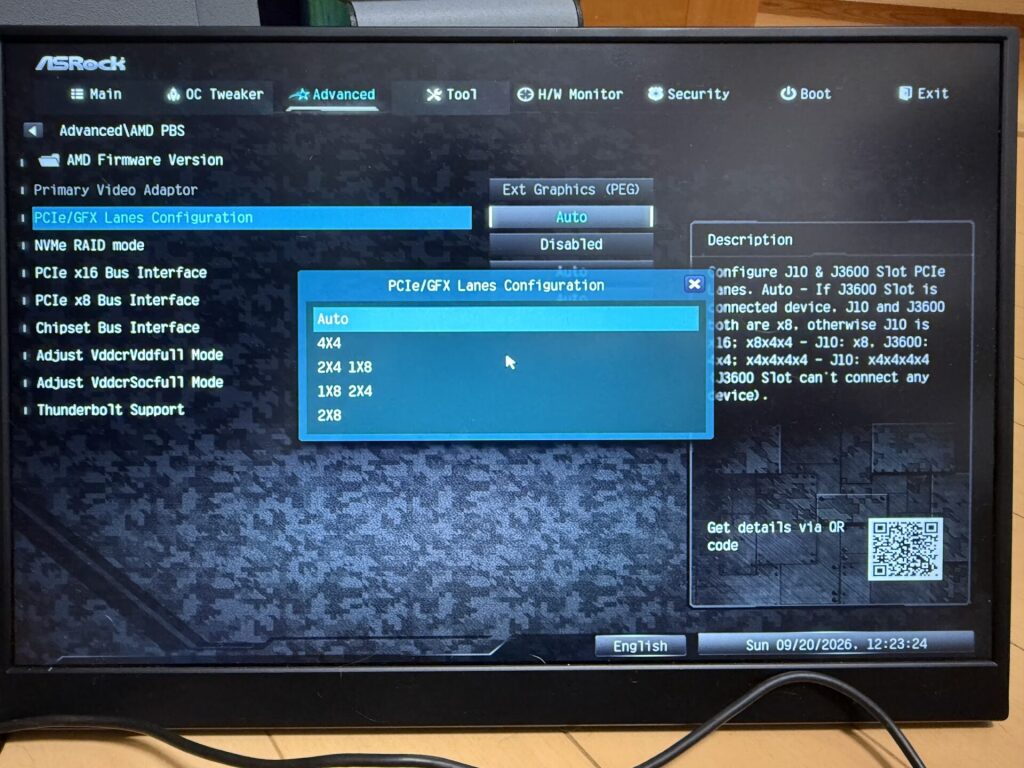
レーン分割について詳しくは以下のレビューをご参照ください。

変換アダプタの冷却は意外と優秀
中国製の空冷アダプタは正直不安でしたが、全条件でサーマルスロットリングは発生せず、SMクロックは1,400MHz以上を維持していました。
最高温度はPCIe機で使ったブロアーファン型のカードで83℃、360mmラジエーターを採用したNVLink機では75℃でした。負荷をかけ続けても性能が落ちなかったのは安心です。
ただし、ブロアー型ファンの騒音は相応なので、居室に置くのは覚悟が要ります。
電源は8ピンの本数に注意
V100は1枚あたり8ピンを複数本要求します。Dualカードでは8ピン×4本が必要で、CPU用と合わせて5~6本必要になりますので、電源ユニットのW数だけでなくコネクタの本数を確認してから購入することをお勧めします。
V100はBF16に対応していない
これはV100全般の落とし穴です。Volta世代はBF16もFP8もハードウェアサポートがないので、HuggingFaceで配布されているBF16の重みをそのまま読ませると起動に失敗します。vLLMなら--dtype float16の指定が必須です。
また、本家vLLMはVolta向けの最適化をほぼ打ち切っているため、今回は1Cat-vLLMというV100特化のフォークを使いました。V100で新しめのモデルを動かすなら、これは事実上の必需品だと思います。
使えるモデルのサイズ感
32GB×2=64GBと聞くと余裕がありそうですが、実際には重みだけでなくKVキャッシュも載せる必要があります。今回使ったLlama 3.3 70BのAWQ 4bit(約40GB)は、KVに十分な余裕が残る良いサイズでした。一方、27BクラスをFP16(約56GB)で動かそうとするとKVの余裕がほぼ残らず、今回は断念しています。4bit量子化の70Bクラスが、この構成のスイートスポットという印象です。
最終的な構成
最終的に、2枚、3基のV100 SXM2を利用して1台のLLMサーバーとして仕立てました。
Dualカードはテンソル並列を生かすために1Cat-vLLMを利用し、シングルカードはOllamaを利用、同時に2つのモデルを扱えるようにしました。
コメント